[Kafka] Kafka 설치 (with KRaft) 및 PUB/SUB 테스트 코드 (with Python) 실습
l Kafka 3.6.1 with KRaft
Apache Kafka(이하 “카프카”)는 실시간으로 기록 스트림을 게시, 구독, 저장 및 처리할 수 있는 분산형 데이터 스트리밍 플랫폼이다. 여러 소스에서 데이터 스트림을 처리하고 여러 사용자에게 전달하도록 설계되었다. 간단히 말해 A지점에서 B지점까지 이동하는 것뿐만 아니라 A지점에서 Z지점을 비롯해 필요한 모든 곳에서 대규모 데이터를 동시에 이동할 수 있다. 카프카는 현재 여러 마이크로서비스 개발 환경에서 많이 사용되고 있다.
카프카는 3.5.2 버전까지는 분산 코디네이션으로 주키퍼(Zookeeper)를 사용하였지만, 3.6.0 버전 부터는 분산 코디네이션에 KRaft를 도입하였다. 현재 이 글을 쓰는 시점의 최신 버전인 3.6.1 버전에도 주키퍼와 KRaft를 모두 지원하고 있어 사용자가 선택하여 사용할 수 있다. 하지만 4.0 버전부터는 주키퍼는 지원하지 않는다고 이후에는 KRaft만 사용될 예정이라고 한다.
Kraft의 장점 및 자세한 설명은 아래 링크를 참고한다.
l KRaft: Apache Kafka Without ZooKeeper : https://developer.confluent.io/learn/kraft/
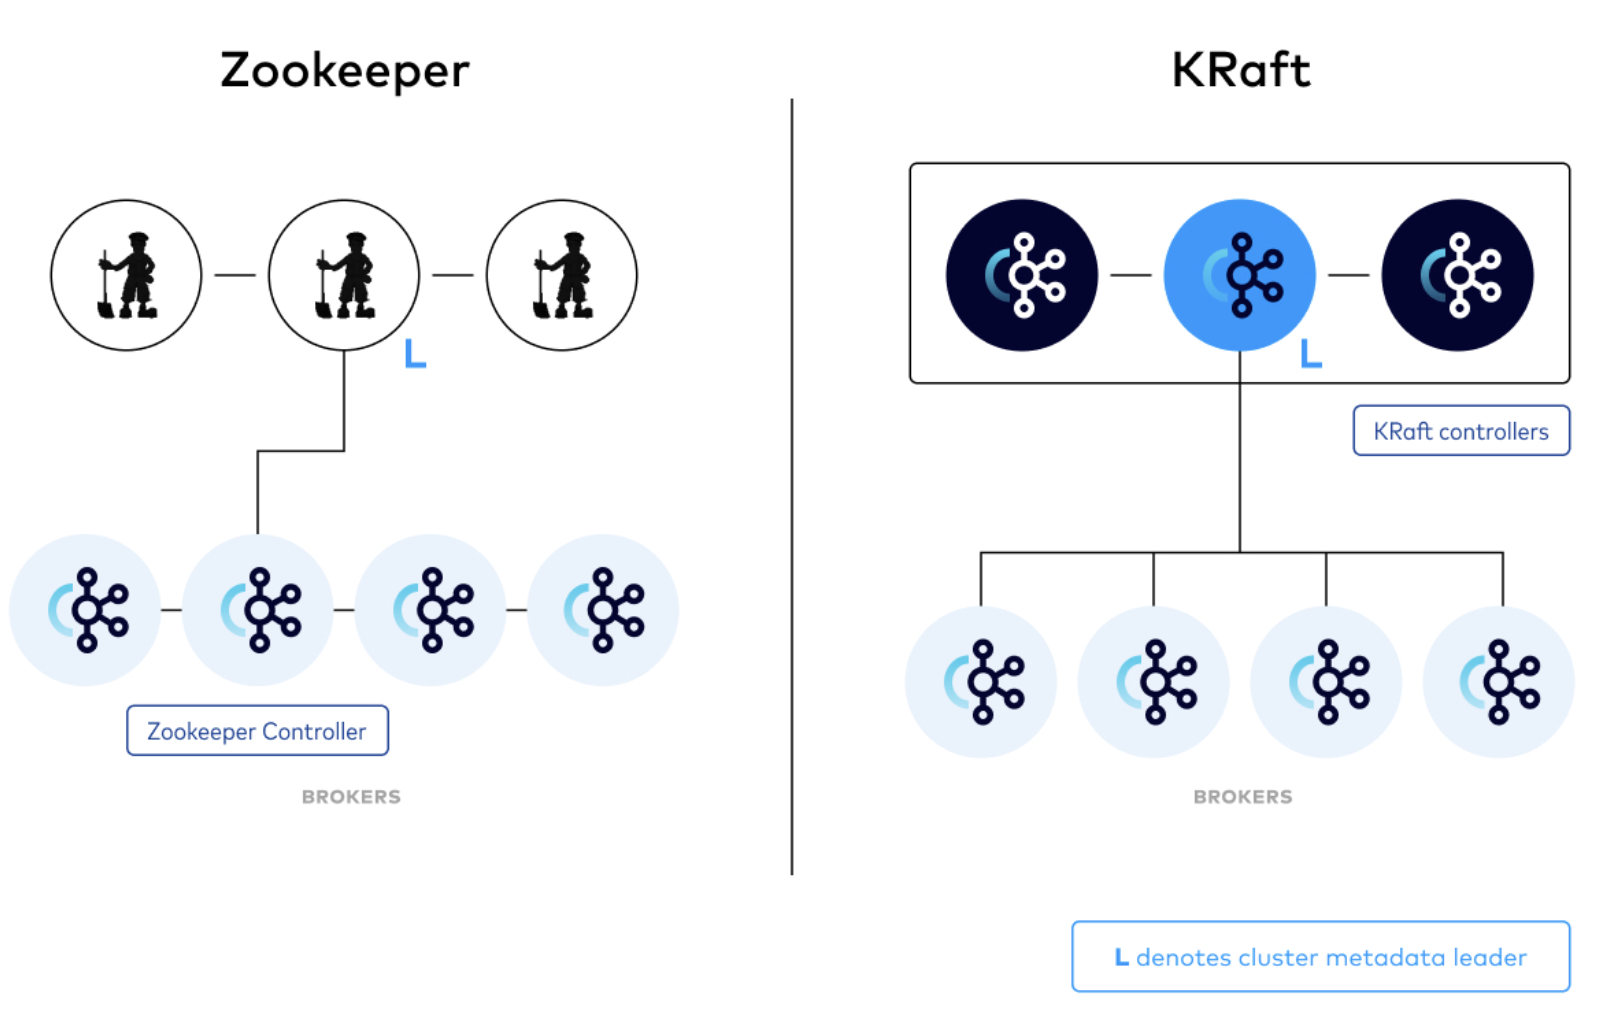
이번 포스트는 카프카 3.6.1 버전을 설치하고, 주키퍼가 아닌 KRaft를 사용하며, 간단히 파이썬 코드로 데이터를 게시(Producer)하고, 구독(Consumer)하는 프로그램을 만들어 본다.
[테스트 환경]
| OS | Ubuntu 22.04.3 LTS |
| CPU | 2 Core |
| Memory | 2 GB |
| Kafka | Kafka 3.6.1 |
카프카를 설치 및 운영하기 위해서는 JDK가 설치되어 있어야 한다. JDK는 11버전이상 사용해야 하며, 이번 실습에서는 17버전을 설치하였다.
| apt-get install openjdk-17-jdk |
카프카 다운로드 페이지에서 원하는 버전을 다운로드 한 후 압축을 해제한다.
l Kafka Download : https://kafka.apache.org/downloads
카프카의 경우 설치형이 아닌 압축을 해제 후 서비스를 실행하여 바로 사용할 수 있다. 실습에서는 3.6.1 버전을 설치한다. 파일을 다운로드 하고, /usr/local 경로에 압축을 해제한다.
| wget https://downloads.apache.org/kafka/3.6.1/kafka_2.13-3.6.1.tgz tar xvf kafka_2.13-3.6.1.tgz -C /usr/local |
관리 및 사용자 편의성을 위해 심볼링크를 생성한다.
| cd /usr/local ln -s kafka_2.13-3.6.1/ kafka |
[server.properties 세팅]
카프카를 실행하기 전에 server.properties를 설정해야 한다. 아래 단계를 따라 설정한다. Properties 파일의 경로는 아래와 같다.
| cd /usr/local/kafka/config/kraft/ |
vi 또는 편집기를 실행하여 server.properties 파일의 내용을 수정한다.
| vi server.properties |
외부 통신을 위해서는 advertised.listeners의 localhost 주소를 카프카 서버 IP로 반드시 변경해야 한다. (필자도 이 부분을 놓쳐서 거의 이틀동안 삽질했다.)
| ############################# Socket Server Settings ############################# #advertised.listeners=PLAINTEXT://localhost:9092 <-주석처리 advertised.listeners=PLAINTEXT://XXX.XXXX.XXXX:9092 <- localhost 대신 카프카 서버의 IP 입력 |
log.dirs은 로그 파일의 경로이다 . 기본값은 /tmp/kraft-combined-logs로 되어 있지만 사용자 편의에 따라 경로를 변경할 수 있다. 필자는 /usr/local/kafka/kraft-combined-logs 경로에 디렉터리를 생성하고, 변경하였다.
| ############################# Log Basics ############################# log.dirs=/usr/local/kafka/kraft-combined-logs |
여기까지 server.properties 수정이 완료 되었으면, 저장하고 편집기를 빠져나온다.
[Kafka 클러스터 ID 생성 및 포맷]
카프카 서버를 시작하기전 클러스터 ID를 생성하고, 스토리지(위에서 지정한 로그 경로의 디렉터리)를 포맷해야 한다.
클러스터 ID는 아래 명령으로 생성할 수 있다.
| cd /usr/local/kafka ./bin/kafka-storage.sh random-uuid |

랜덤한 UUID로 클러스터 ID가 생성되면 해당 ID를 사용하여 스토리지 디렉터리를 포맷한다.
| cd /usr/local/kafka ./bin/kafka-storage.sh format -t J9wwo7p2RHe9-4PiP4KbBw -c ./config/kraft/server.properties |

[카프카 서버 시작 / 중지]
위 단계까지 완료되었으면 이제 카프카 서버를 시작한다. 카프카 서버의 시작 및 중지는 아래 명령을 사용할 수 있다.
| #Start Service cd /usr/local/kafka ./bin/kafka-server-start.sh -daemon ./config/kraft/server.properties #Stop Service cd cd /usr/local/kafka ./bin/kafka-server-stop.sh -daemon ./config/kraft/server.properties |
서비스가 정상적으로 실행되었는지 확인하려면 아래 스크립트를 사용하여 데몬 활성화 상태 및 포트 오픈 여부를 확인할 수 있다.
| ps -ef | grep java | grep kraft/server.properties |
| netstat -antp | grep 9092 |

| netstat -antp | grep 9093 |

[Producer / Consumer Test]
카프카 서비스가 정상적으로 실행되었으면, 간단히 토픽을 하나 생성하고, 프로듀서, 컨슈머 테스트를 진행한다.
토픽 생성은 아래 스크립트를 사용한다. 실습에서는 토픽의 이름을 topic1 이라고 생성하였다.
| #Create Topic cd /usr/local/kafka ./bin/kafka-topics.sh --create --topic topic1 --bootstrap-server localhost:9092 --replication-factor 1 --partitions 1 #Delete Topic ./bin/kafka-topics.sh --delete --topic topic1 --bootstrap-server localhost:9092 |
현재 생성되어 있는 토픽을 확인하는 명령은 아래와 같다.
| cd /usr/local/kafka ./bin/kafka-topics.sh --bootstrap-server=localhost:9092 --list |
카프카에 topic1 메시지를 게시한다.
| cd /usr/local/kafka ./bin/kafka-console-producer.sh --broker-list localhost:9092 --topic topic1 > Input message > Input another message #End Input Ctrl+C |
카프카의 topic1의 메시지를 구독한다.
| cd /usr/local/kafka ./bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic topic1 --from-beginning |

[파이썬으로 Producer, Consumer 테스트]
파이썬으로 간단한 Producer, Consumer 테스트 코드를 작성해 본다. 우선 카프카 커넥터를 설치해야 한다. 다양한 커넥터가 있지만 실습에서는 kafka-python 커넥터를 사용한다.
| pip3 install kafka-python |
아래 코드는 producer 코드로 1 ~ 10까지 반복하며 topic1에 메시지를 입력한다. (파이썬 코드에 관한 설명은 생략한다.)
| from kafka import KafkaProducer from json import dumps import time import traceback producer = KafkaProducer( acks=0, compression_type='gzip', bootstrap_servers=['XXX.XXX.XXX.XXXX:9092'], value_serializer=lambda x:dumps(x).encode('utf-8') ) start = time.time() try: for i in range(10): data = {'str' : 'result'+str(i)} producer.send('topic1', value=data) producer.flush() producer.close() print('[Done]', time.time() - start) except: traceback.print_exc() |
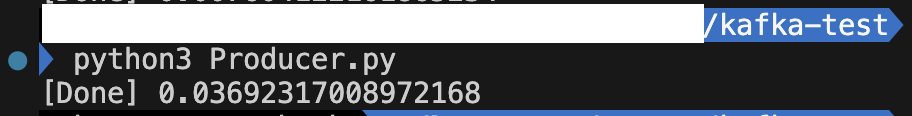
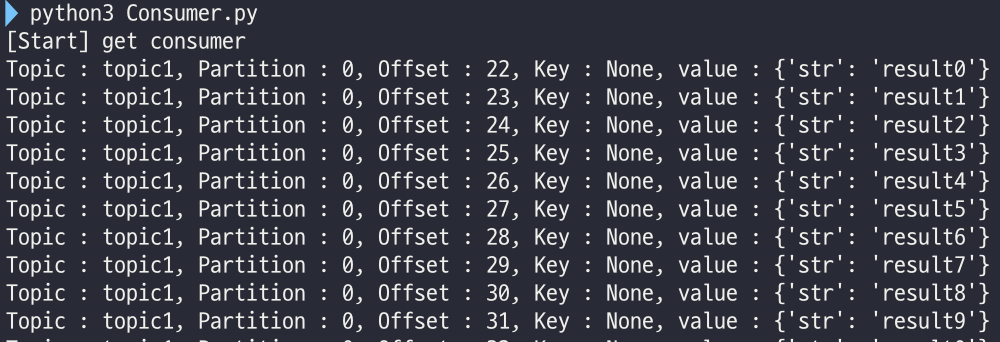
아래 코드는 Consumer 코드로 topic1에 있는 메시지를 처음부터 구독한다.
| from kafka import KafkaConsumer from json import loads consumer = KafkaConsumer( 'topic1', bootstrap_servers=['XXX.XXX.XXX.XXX:9092'], auto_offset_reset='earliest', enable_auto_commit=True, group_id='1', value_deserializer=lambda x: loads(x.decode('utf-8')), consumer_timeout_ms=1000 ) print('[Start] get consumer') for message in consumer: print(f'Topic : {message.topic}, Partition : {message.partition}, Offset : {message.offset}, Key : {message.key}, value : {message.value}') print('[End] get consumer') |
지금까지 카프카 설치 및 간단하게 프로슈머, 컨슈머 사용법에 대해서 알아보았다. 카프카는 대규모 메시징 시스템에서 많이 사용된다. 그렇기 때문에 단독 서버가 아닌 클러스터로 구성하여 사용하는 경우가 많다. 카프카의 특성을 잘 이해하고, 토픽 및 파티션 최적화 설계로 안정적인 서비스 구성이 될 수 있도록 반드시 추가 학습을 진행할 것을 권장한다.
[참고자료]
KRaft: Apache Kafka Without ZooKeeper : https://developer.confluent.io/learn/kraft/
Mark KRaft as Production Ready : https://cwiki.apache.org/confluence/display/KAFKA/KIP-833%3A+Mark+KRaft+as+Production+Ready
2024-01-09 / Sungwook Kang / https://sungwookkang.com
KAFKA, 아파치 카프카, 카프카 설치, Install Kafka, Apache Kafka, Kraft, 카프카 스트림, producer, consumer
'SW Engineering > DevOps, SRE' 카테고리의 다른 글
| [Kafka] Kafka 클러스터 4노드 구성 - Controller, Broker 혼합해서 구성하기 (0) | 2024.01.17 |
|---|---|
| [Kafka] KRaft 설정 파일 및 기본 속성 정의 알아보기 (0) | 2024.01.11 |
| [Grafana] Grafana에서 이메일 알림 보내기 (0) | 2023.11.17 |
| [Kubernetes] 쿠버네티스에서 POD(파드)란? 그리고 POD 생성하기 (0) | 2023.09.08 |
| [kubernetes] minikube에서 로컬 docker image 사용하기 (0) | 2023.09.07 |